
プロジェクト記録 / Community Directory 審査完了 · v1.8.3
Japanese Reading Assistant:辞書・文法解析・任意のPDF OCRを読書画面に残す
選択中の日本語に一つの訳文、語彙、文法解析を表示する Obsidian プラグイン。テキストはモデル設定だけで使え、PDF OCR は任意。結果は日ごとの Vault ノートに保存できる。
- Obsidian
- 日本語学習
- OCR
- Ollama
- DeepSeek
日本語を読むときに流れを止めるのは、未知語そのものよりも、辞書、翻訳、文法解説、原文を何度も往復することです。このプラグインはその操作をObsidianの現在の画面に残します。短い選択ではコンパクトな語彙説明を、文では一度だけモデルに問い合わせ、同じ訳文を共有する語彙ビューと文法ビューを表示します。
リポジトリは公開済みです:Normanchine/obsidian-japanese-reading-assistant。v1.8.3 の Community Directory 自動審査は完了していますが、クライアント側のカタログ反映は GitHub Release より遅れることがあります。GitHub Release からの手動導入、または BRAT によるベータ導入も可能です。
主な使い方は意図的に簡単です。ローカル Ollama または OpenAI 互換クラウド API を設定して、Markdown、Live Preview、Reading view で文字を選択します。OCR は前提条件ではなく、PDF の画像領域を選ぶときだけ設定します。
一回の解析を、一つの文に結び付ける
目的は長い一般論の解説を作ることではありません。文には一つの共通訳を残し、語彙ビューでは辞書上の意味とこの文での意味を分けます。文法ビューでは原文の該当箇所を色付きの波線で示し、短い説明カードに対応させます。これにより、解説だけが原文から離れてしまうことを避けます。
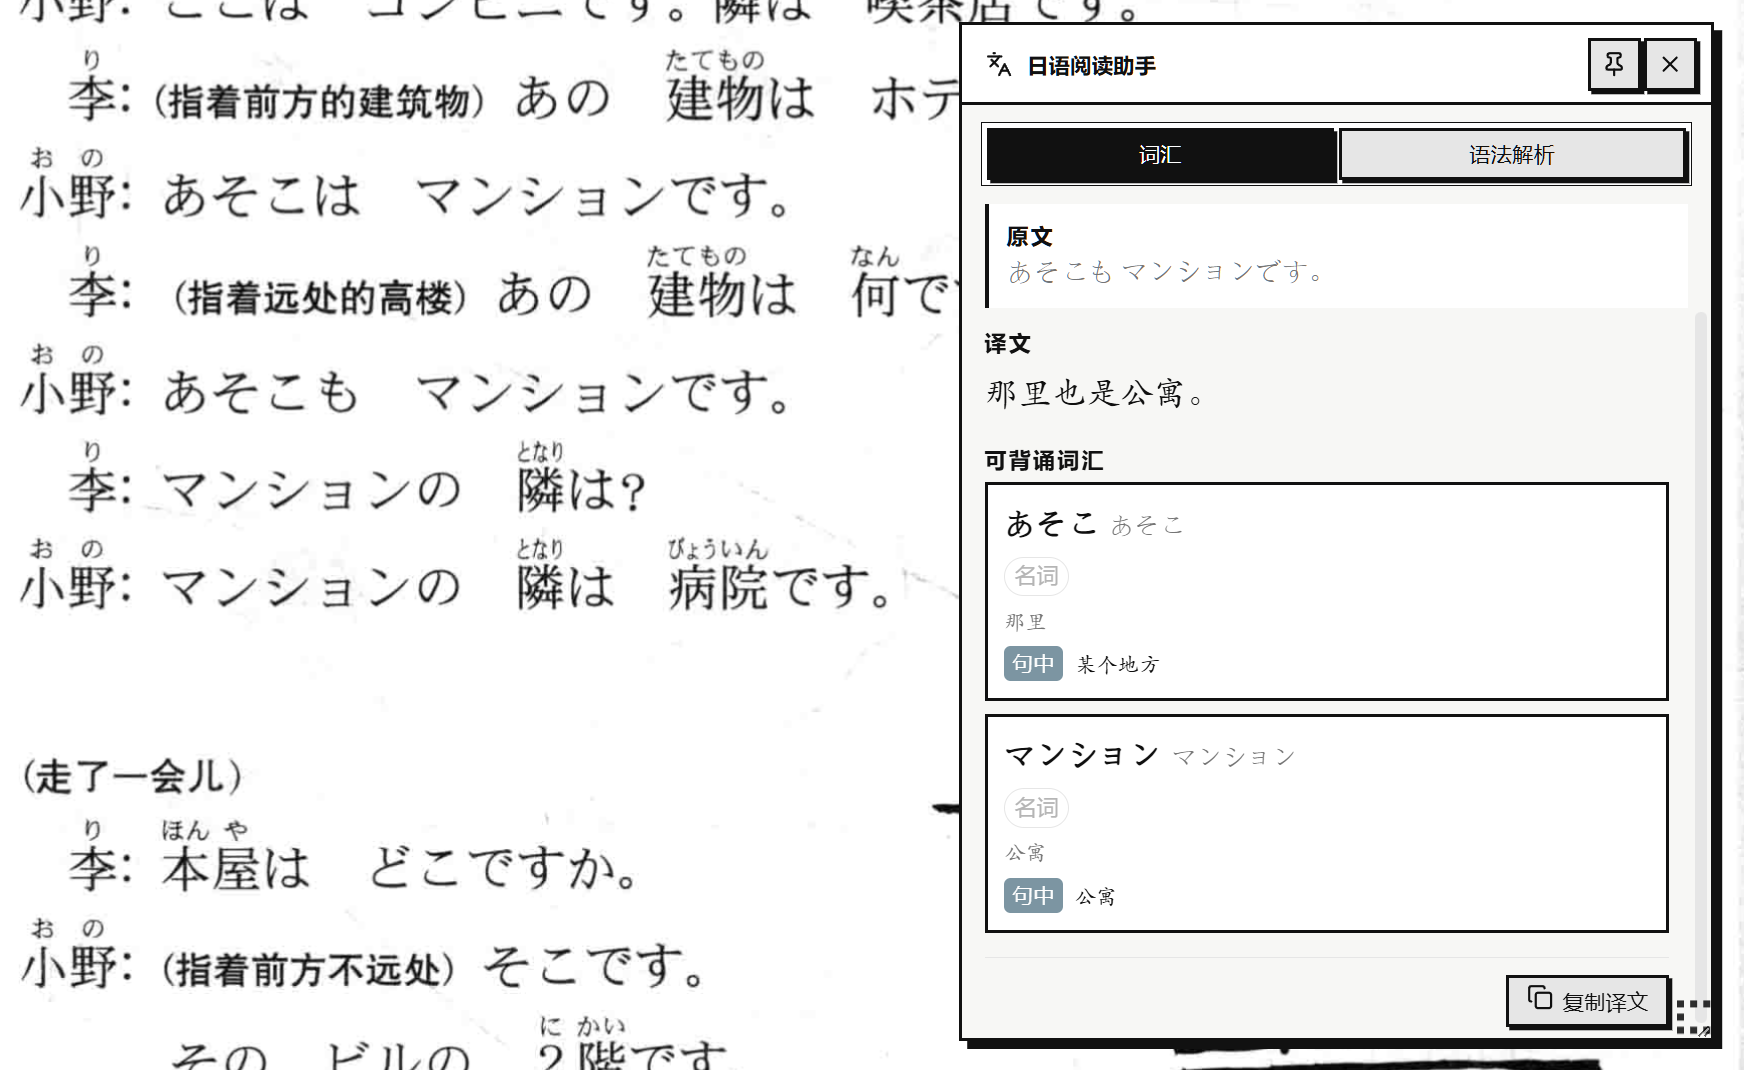
語彙ビューは現在の文から始まります。「文中」は新しい辞書項目ではなく、この文での働きを示します。
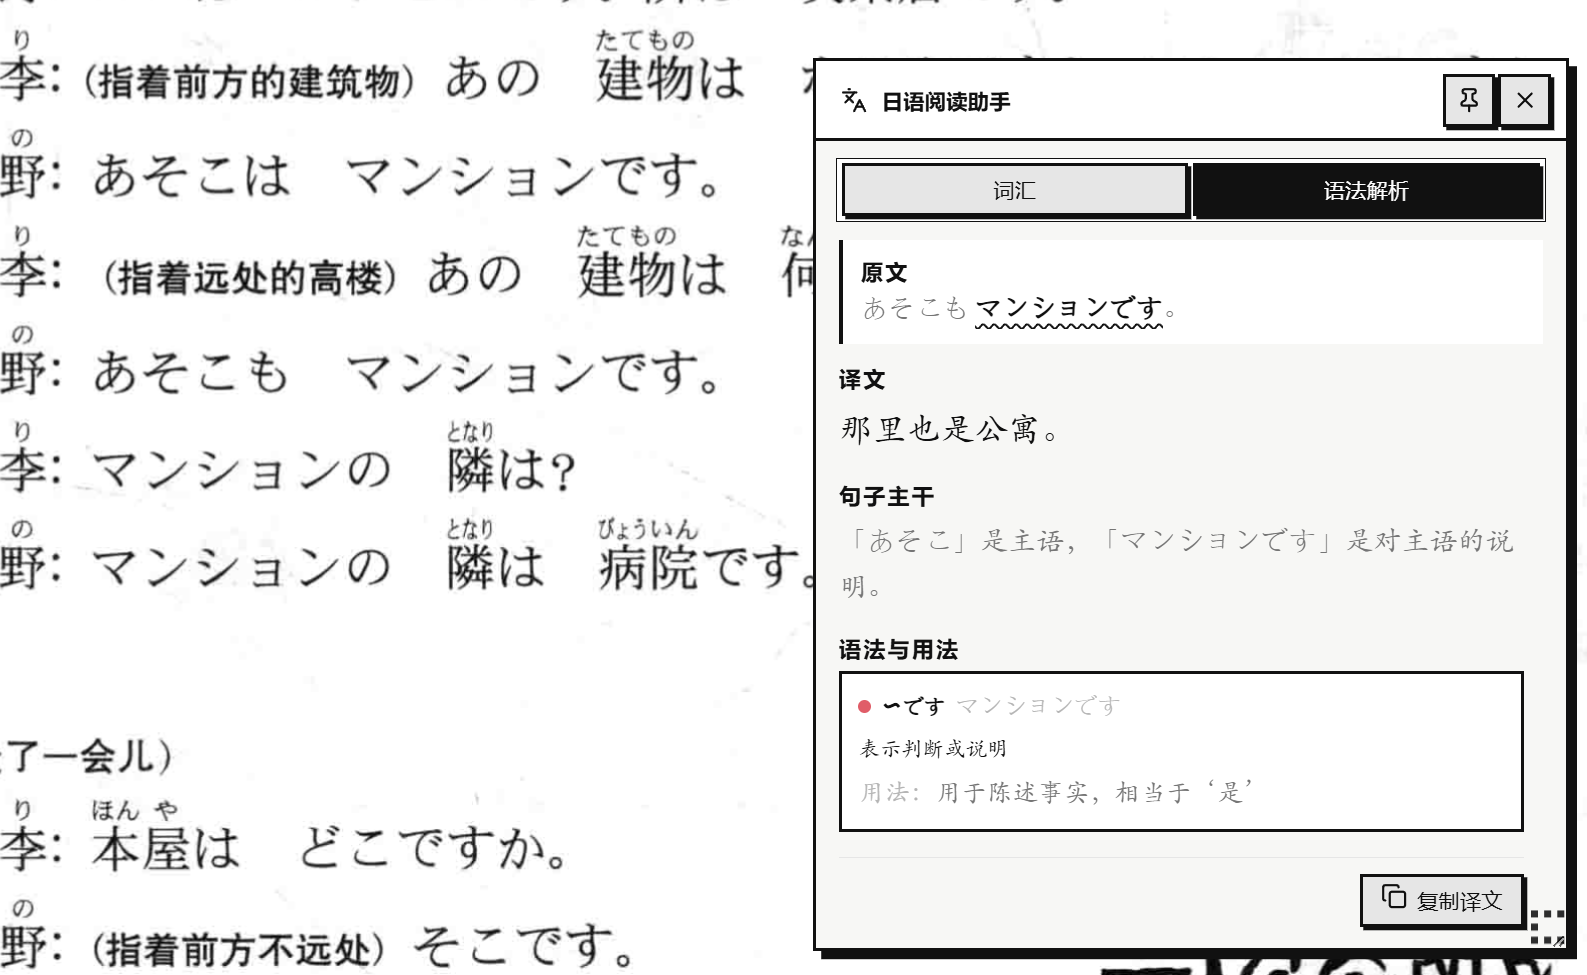
文法ビューは「〜です」を原文中に示し、この文での判断・説明の役割を短く説明します。結果は固定、移動、リサイズできる非モーダルウィンドウに表示され、原文を置き換えません。
復習したい部分だけを残す
即時解析を別のタスク管理にする必要はありません。「学習ノートに保存」は、現在表示されている原文、共通訳、少量の語彙、文法項目だけを指定した Vault の Markdown ファイルに書き込みます。同じ日の複数記録は一つの日付見出しにまとまり、分単位の時刻は書きません。
保存はすべての選択を自動収集する機能ではなく、読書後の軽いメモです。明示的に保存しない結果は従来どおりメモリ内だけに残ります。
Obsidianを離れないPDF OCR
教材やスキャンされた読本では、文字を選択できないことがあります。Obsidian内蔵PDFビューアでは、Altを押しながら小さな範囲をドラッグすると、その範囲だけがユーザー設定の OCR エンジンに送られます。認識結果は通常の文と同じ翻訳、語彙、文法の流れに入ります。
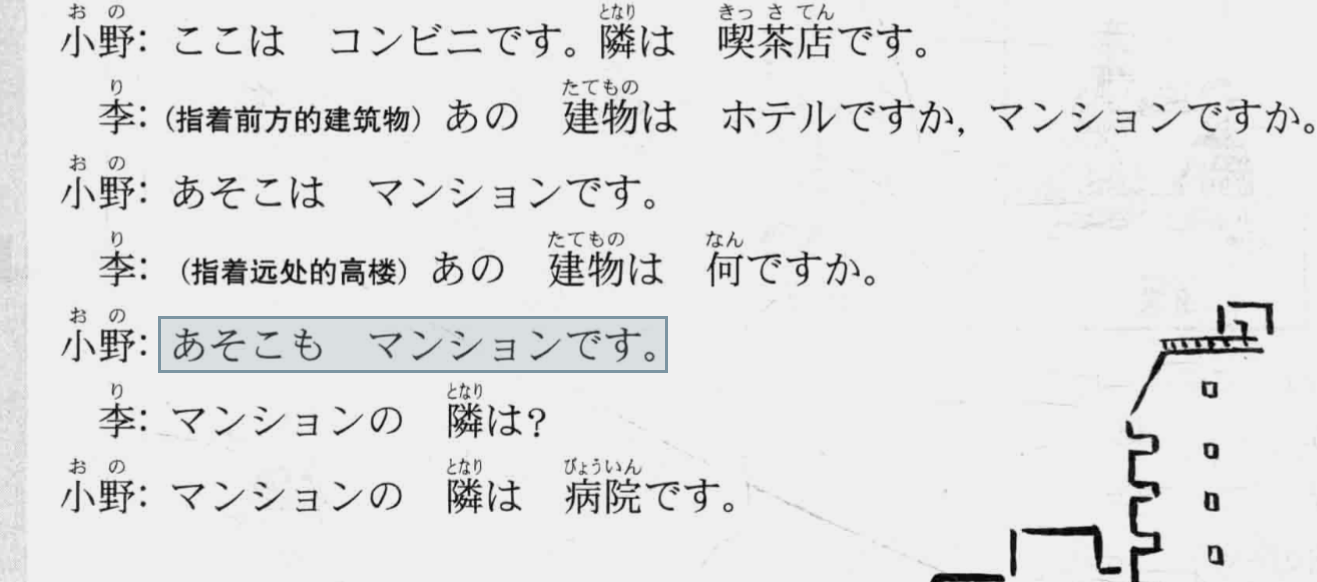
OCRに渡るのは読者が描いた範囲だけで、PDF全体ではありません。小さい文字では原画像と表示倍率の影響を受けるため、ページを拡大してから選択する方が安定します。
この機能は意図的に狭くしています。PDFを完全な電子書籍に変換するものではありません。ローカル CPU の PP-OCRv5 またはインストール済み Ollama 視覚モデルを選べます。設定画面には PP-OCR 用の配布リポジトリと、ユーザーが明示的に実行する一行の導入コマンドがあります。Obsidian の起動時にプラグインが依存関係をダウンロードや導入することはありません。
モデル、データ、導入の境界
テキスト解析にはローカル Ollama、またはユーザーが設定した OpenAI 互換クラウドエンドポイントを使えます。既定値は DeepSeek 向けです。Ollama は端末または信頼できる LAN 上で動かせますが、クラウドモードでは現在の選択文と固定の解析プロンプトが設定済み API へ送信されます。プラグインはノート全体、ファイル名、Vault パス、周辺ノートを送信せず、テレメトリも含みません。PDF OCR に送られるのは明示的に描いた範囲だけで、画像は Vault に保存されません。
導入には Obsidian 1.11.5 以降と、設定済みの解析プロバイダーが一つ必要です。Python 3.11 とローカルサービスが必要なのは PP-OCRv5 を選んだ場合だけで、Ollama 視覚モデル利用者には不要です。手動導入、BRAT、二つの OCR 設定経路はリポジトリの README にあります。
まだ検証していない部分
表示結果はユーザーが明示的に日付ごとの Markdown 記録として保存できますが、語彙カードと間隔反復への書き出しはまだ内蔵機能ではありません。PDF OCRはObsidian内蔵PDFビューアの表示中ページを対象にしており、EPUB、Canvas、第三者製リーダーのための汎用OCRではありません。出力品質は、選んだモデルが構造化JSON形式を安定して守れるかどうかにも左右されます。
そのため現時点では、これは読書中の瞬間を支える小さな助手であって、完全な日本語コースや暗記システムではありません。復習カードを加える前に、それが読後の整理コストを実際に減らすかを確かめるのが次の検証になります。